AI繪圖-花錢了事的Lora訓練法(使用tensorhub.art)
1.簡介
AI繪圖的Lora訓練雖稱不上超高難度,但總歸還是有個技術門檻,而且實際操作上還附帶一堆SOP。
在SD1.5的時代我寫過Lora的教學文,即使我試著把每個流程分門別類的拆開,試著讓一切淺顯易懂,但它的複雜度就是擺在那,再怎麼簡化解釋我也是還是寫了三篇文章才把Lora的訓練過程解釋完:
AI繪圖-用Lora打造你的夢幻模特兒吧!三集之一:Kohya's GUI安裝
AI繪圖-用Lora打造你的夢幻模特兒吧!三集之二:訓練Lora模型
AI繪圖-用Lora打造你的夢幻模特兒吧!三集之三:使用Lora繪製圖片
這三篇文章的重點就是:先安裝好SD本體,因為訓練過程中會需要用到一些SD本體的附加功能。
何況訓練Lora不就是為了在SD裡面畫畫,連SD主體都沒有幹嘛訓練Lora。
接著是安裝Kohya's GUI軟體,這是訓練Lora的核心軟體。
最後是訓練素材的準備,可能要栽切圖片,調整解析度等等。
每一個小步驟拆開又都可以獨立解釋一長串,要說不複雜是騙人的。
再往後,AI繪圖的世界快速的迭代變革著,我當初寫的文章很快就不適用了,SD體系又出了SD3.0,SD3.5,SDXL,還有Illustrious這類分支的出現,更遑論還有FLUX,QWEN,Z Image等等眾多體系。
不同體系不同版本的Lora訓練流程可能就不同,我實在也沒心力不停的追著這些五花八門的技術跑。
後來我決定花錢了事,真是輕鬆多了。
不要覺得靠自己的毅力處理等於免費解決一切,你要記得時間也是成本,尤其成年人的時間更是寶貴。
花個數十元至百元左右的台幣就能一站式的解決所有流程,不算貴又解決了很多麻煩。
以下是以tensorhub.art這個網站做為示範,但我會用這個網站純粹是我用的久也用的習慣了,倒不是只有這個網站提供Lora訓練功能,其它類似這種把原生繪圖系統改成線上版的網站應該都有類似的功能。
這個網站還有一個大眾化(禁止NSFW)的版本:https://tensor.art/
有興趣的可以比價一下,但我粗估營運方其實都精算過了,雖然表面上這個大眾版網站的點數有便宜一點,但最終消耗成本其實八九不離十。
2.成本試算
成本其實無法簡單計算,但可以抓一個大概的範圍。
1個點數依據不同的訂閱方案及購買數量而有不同的價格,越高級的方案就越便宜。
1個點數的價格介於0.X~1元台幣。
而實際訓練點數依你的訓練模型與素材數量而定。
以主流的FLUX或是SD體系模型來說,上傳一個圖片素材並且訓練十個輪次(預設值)會消耗7個點數。
如果是較舊的或是特惠模型就會再便宜一些,而最新潮的大模型就會更貴一些。
(點數消耗依機制與優惠狀況可能會浮動)。
此處的單點數成本我們用比較貴的1元來計算,而素材總量我們當做20張圖,並假設選了主流的FLUX模型,並以預設值來訓練十個輪次,在這種情況下的訓練總成本就會是140個點數,大約就是台幣140元。
當然這是以最基礎最貴的方式來計算。
如果用比較優惠的方案購入點數,實際上訓練出一個Lora的成本會是在數十元台幣的水準。
3.操作流程:
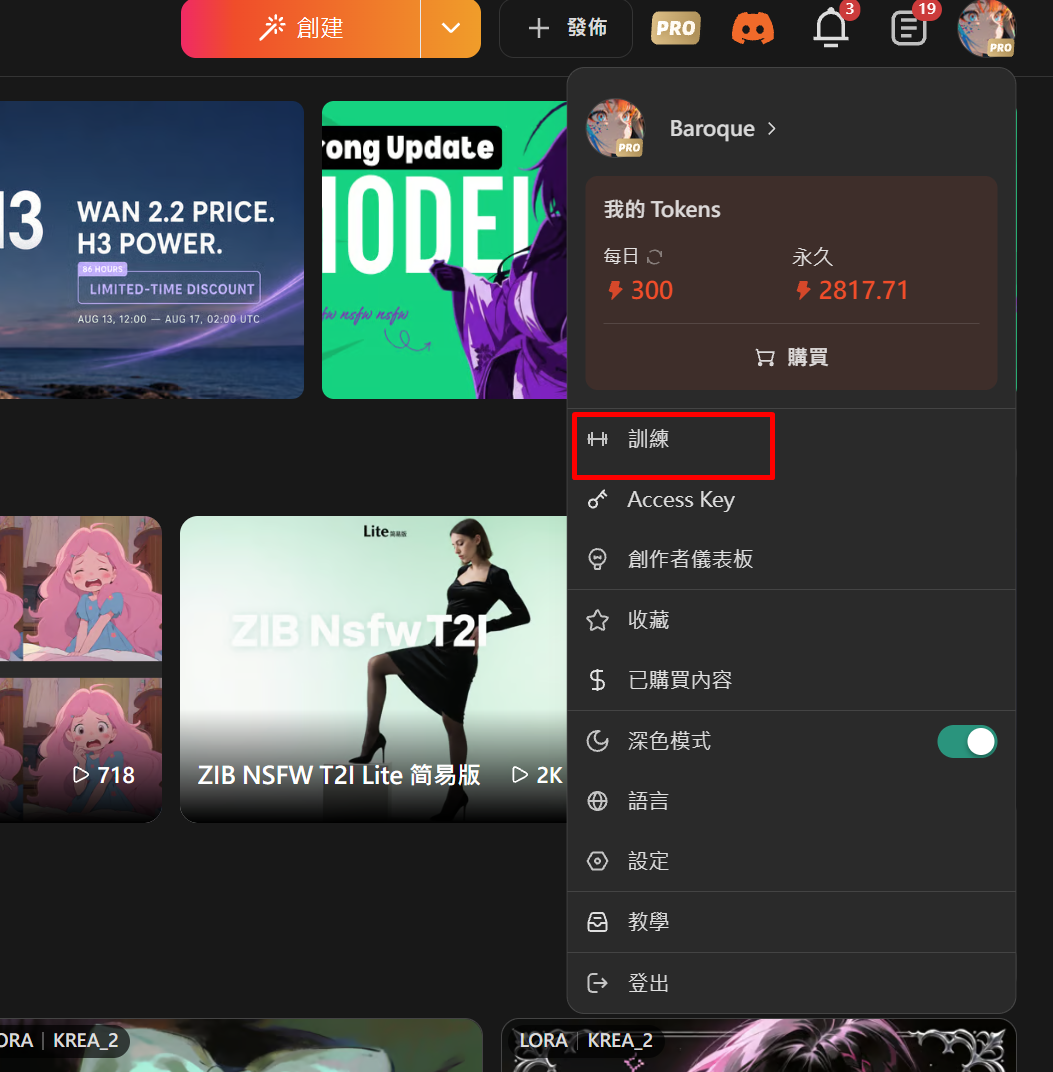
A.登入帳號後點選右上選單的"訓練"
B.上傳訓練圖源,並選擇訓練模型與細節設定:
在這個介面中可以上傳訓練素材,建議不要貪多,應該要重質不重量,大約十幾至二十幾張圖就夠了。
此處大多數值設定照預設值就行了,比較重要的是模型的選擇,寫實類的圖源就要選擇寫實類的模型,
動漫類的圖源就選動漫類的模型。
如果預設選單沒有你想要的模型可以選擇"自訂"就會列出全站模型,任君挑選。
此處選擇FLUX模型,訓練出的就是FLUX Lora,選擇SDXL模型就是訓練出SDXL Lora,依此類推。
"觸發詞"最好設定一個專屬於這個Lora的觸發詞,而"模型效果預覽提示"是輸入訓練過程中要用的prompt,認真的填寫一下可以幫助自己在訓練過程中判斷訓練品質,但只是輔助性質,與訓練結果品質沒直接關係。
而上方有一個"影像處理的按鈕,內建了幾個好用的預處理功能,例如圖片裁切或去背,而且是全自動的,不用再每張圖手動調整。
而"標記"可以自動幫圖片加上訓練tag,這一步會消耗一些點數,若你真的不想要再額外消耗點數的話,目前也有很多網站提供了免費的圖片tag功能。
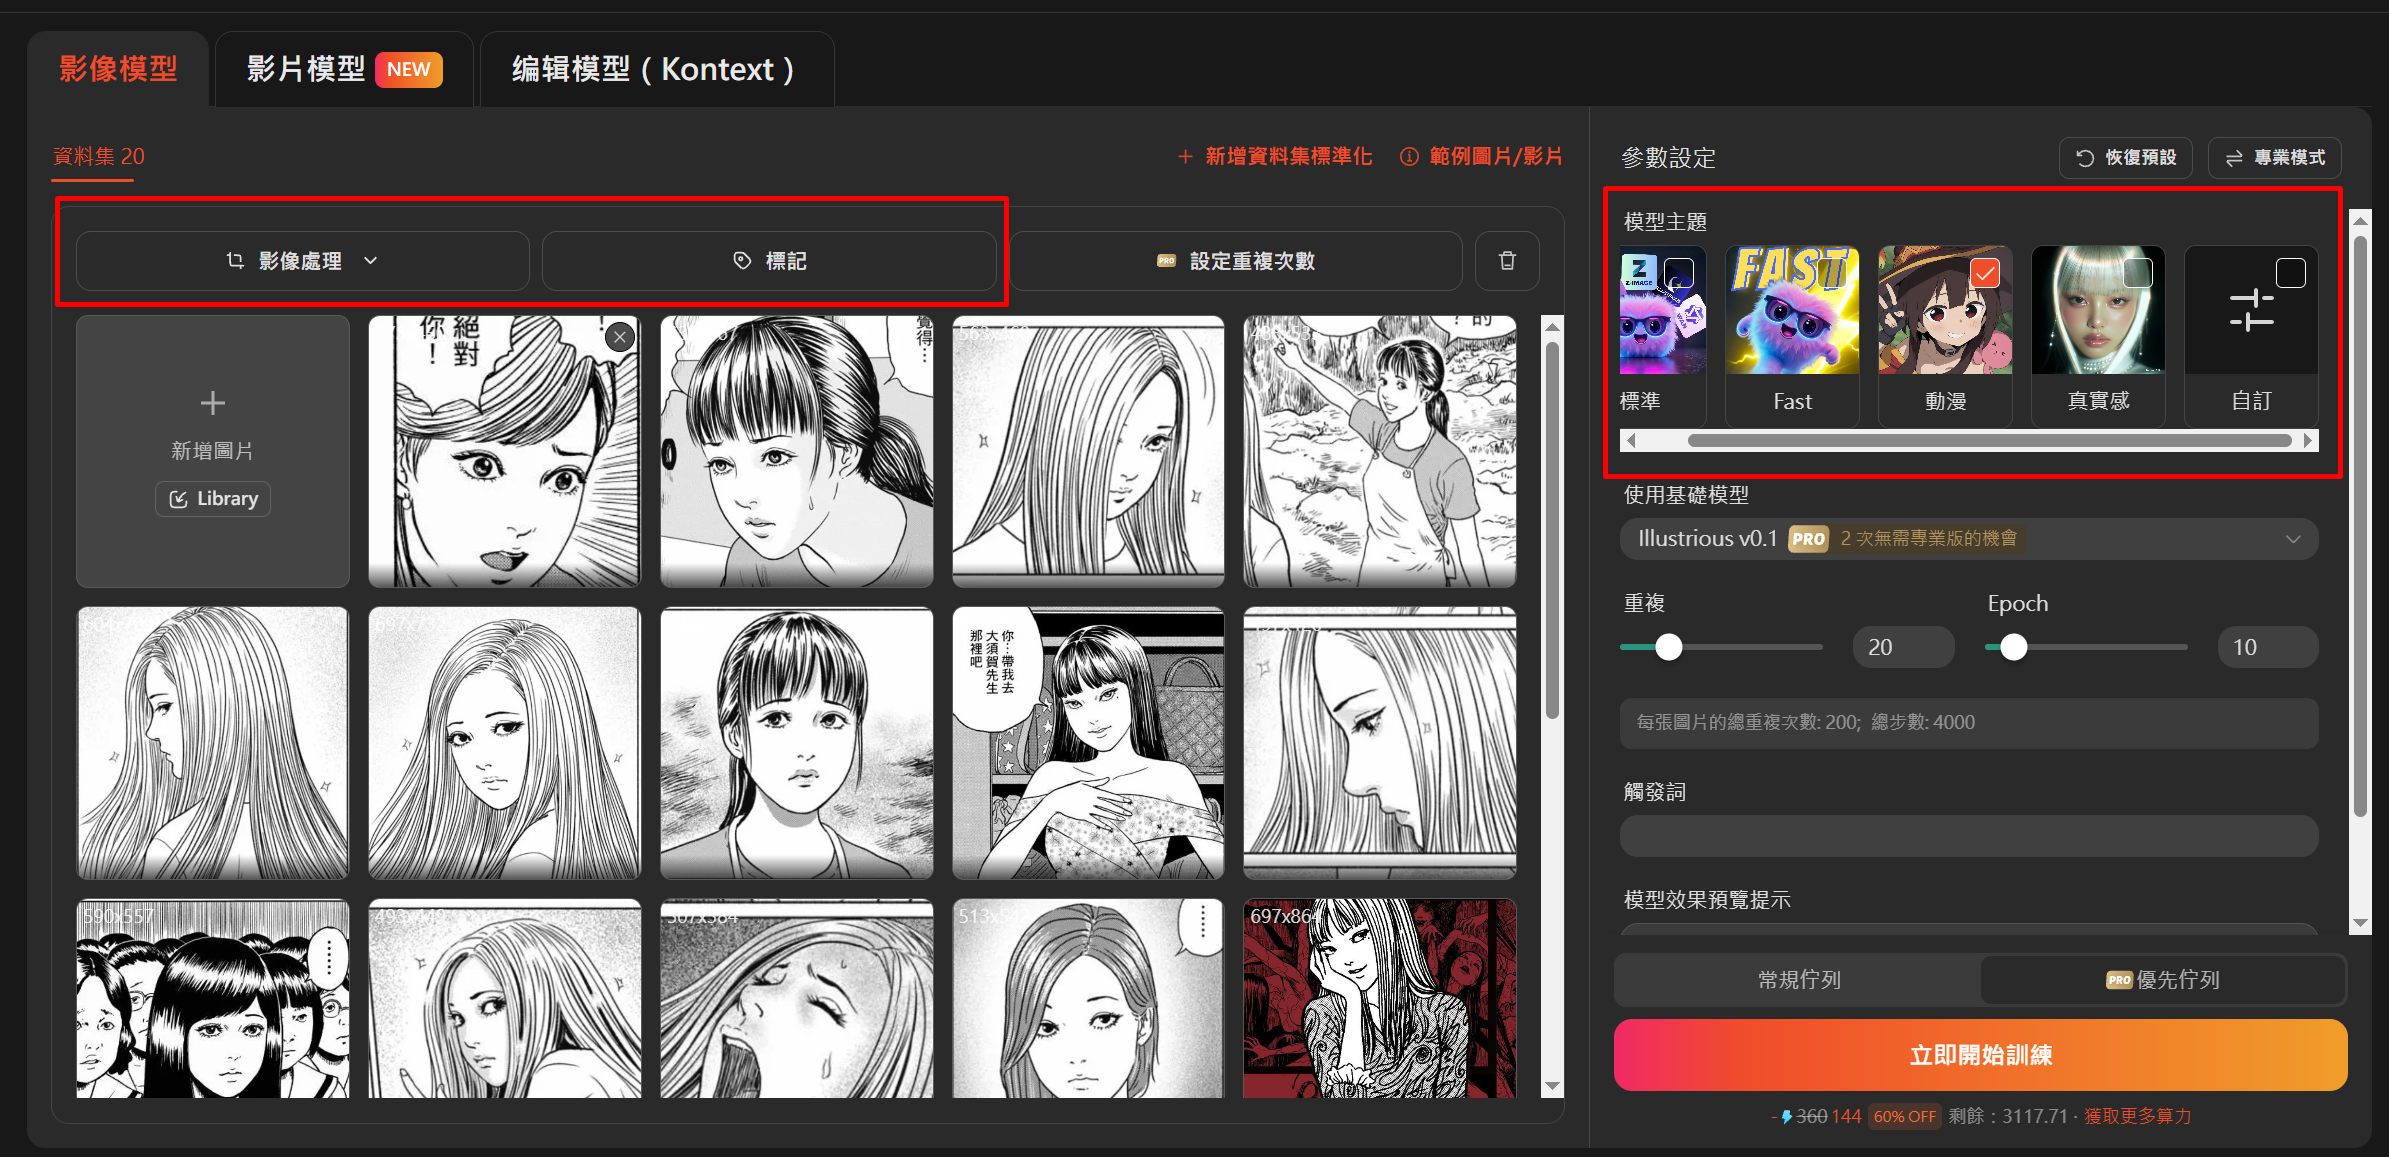
(這邊以上傳伊藤潤二的漫畫圖為例子)
C.開始訓練
一切準備就緒之後,就可以點擊開始訓練了。以20張圖訓練十輪來說,可能要到一兩個小時以上。
訓練過程如下圖示:
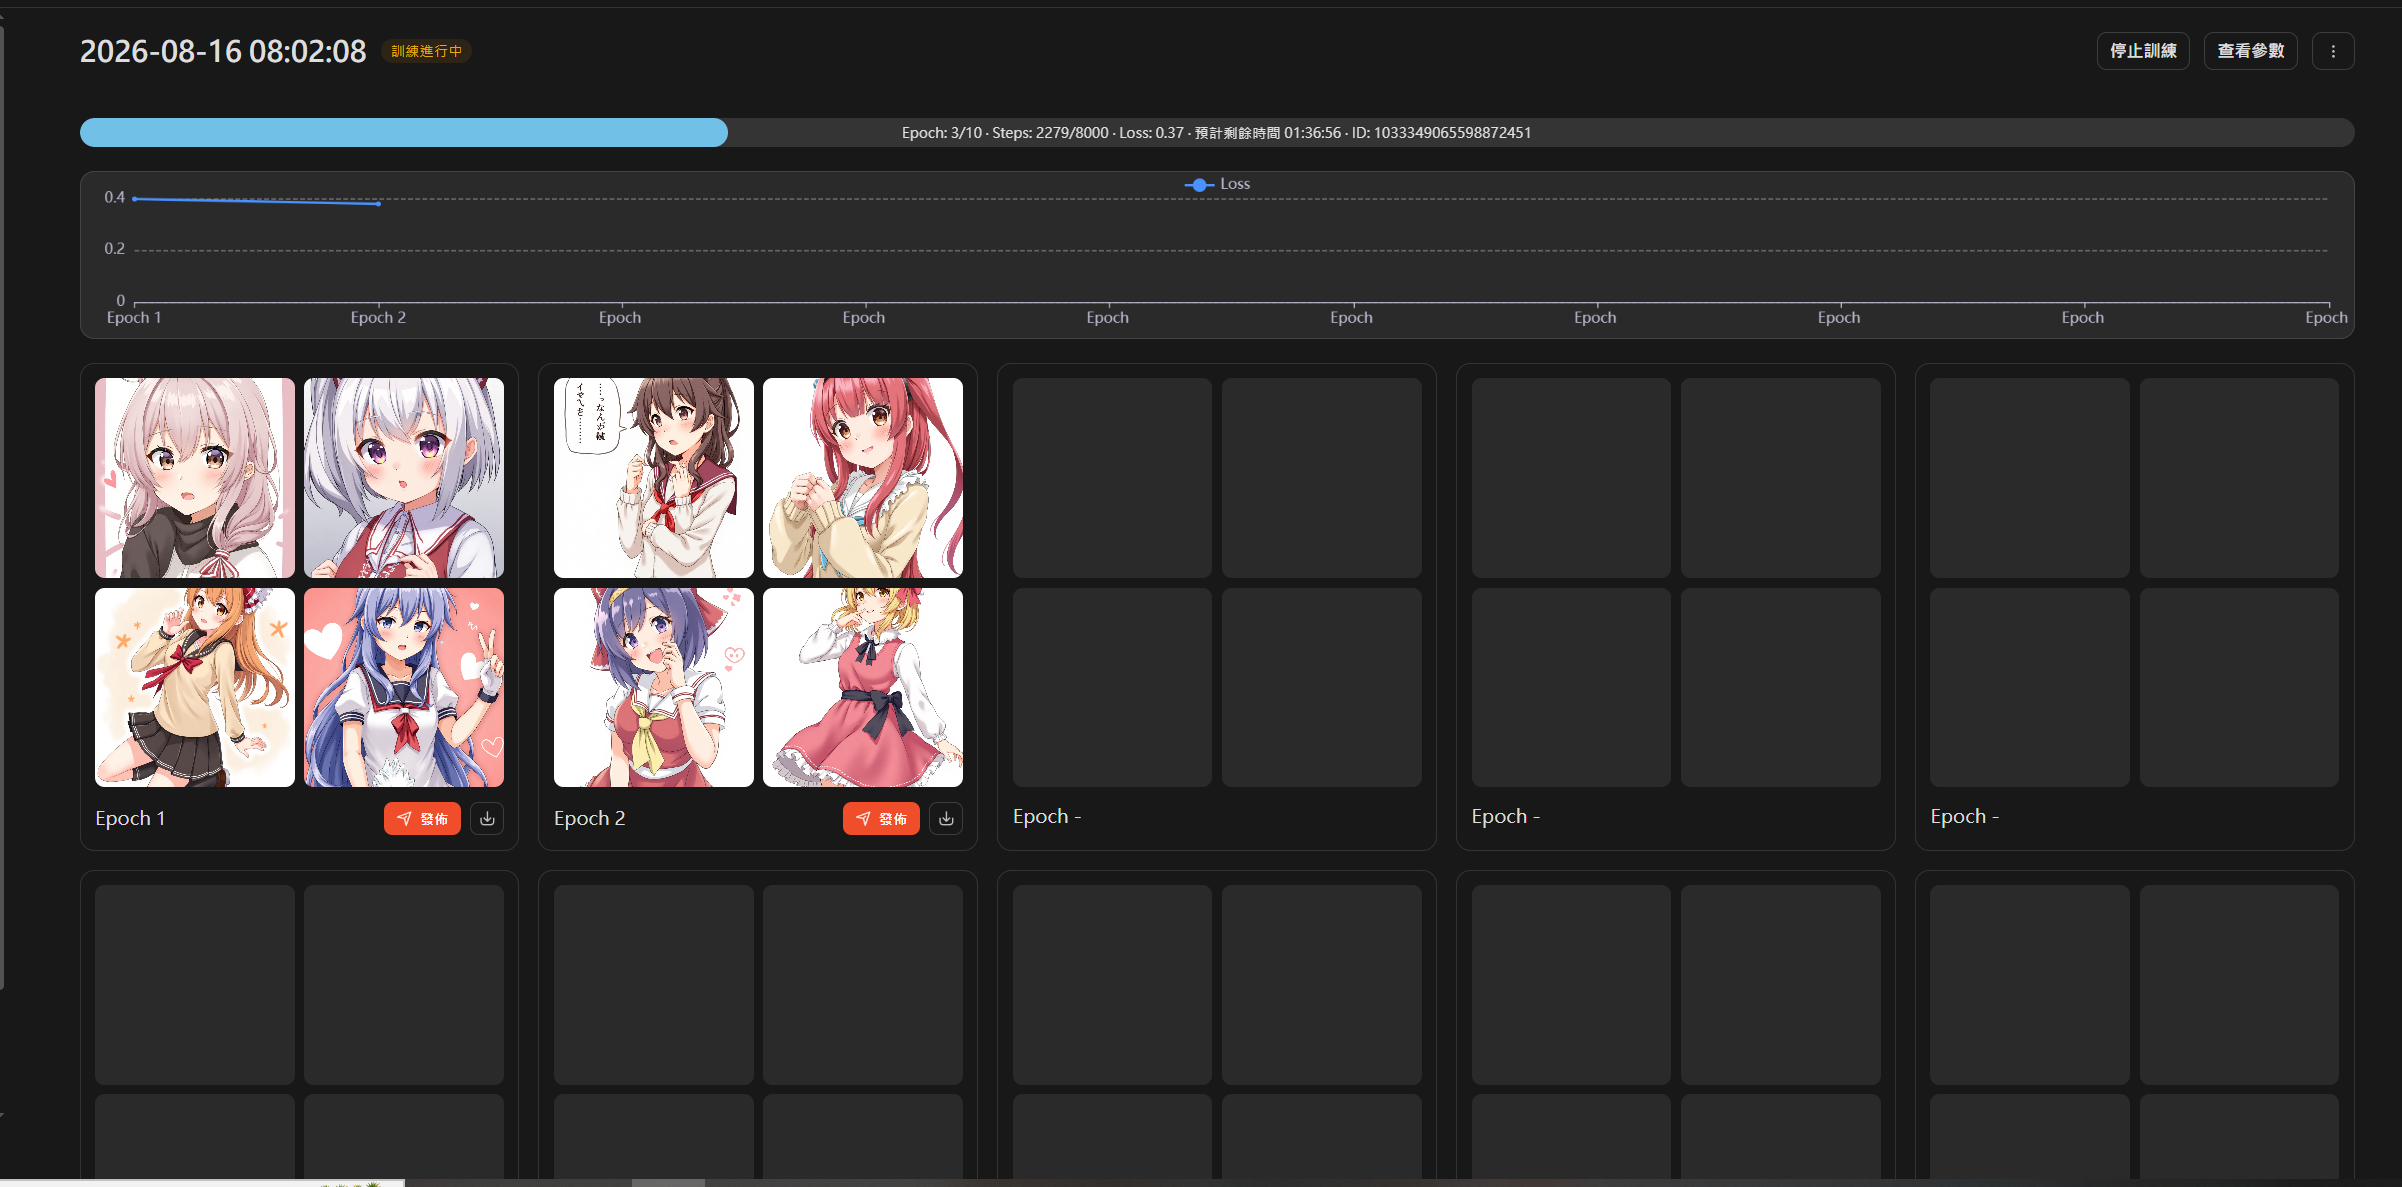
訓練過程中可以發現隨著訓練輪次,預覽圖越來越接近原圖風格:
通常在Epoch5之後的品質就會漸漸可以接受,我自己的習慣是會抓Epoch6,8,10三個檔次的訓練結果來比較看看。
訓練完成的輪次就會顯示"發佈"按鈕,選擇想要的輪次按下發佈鈕。
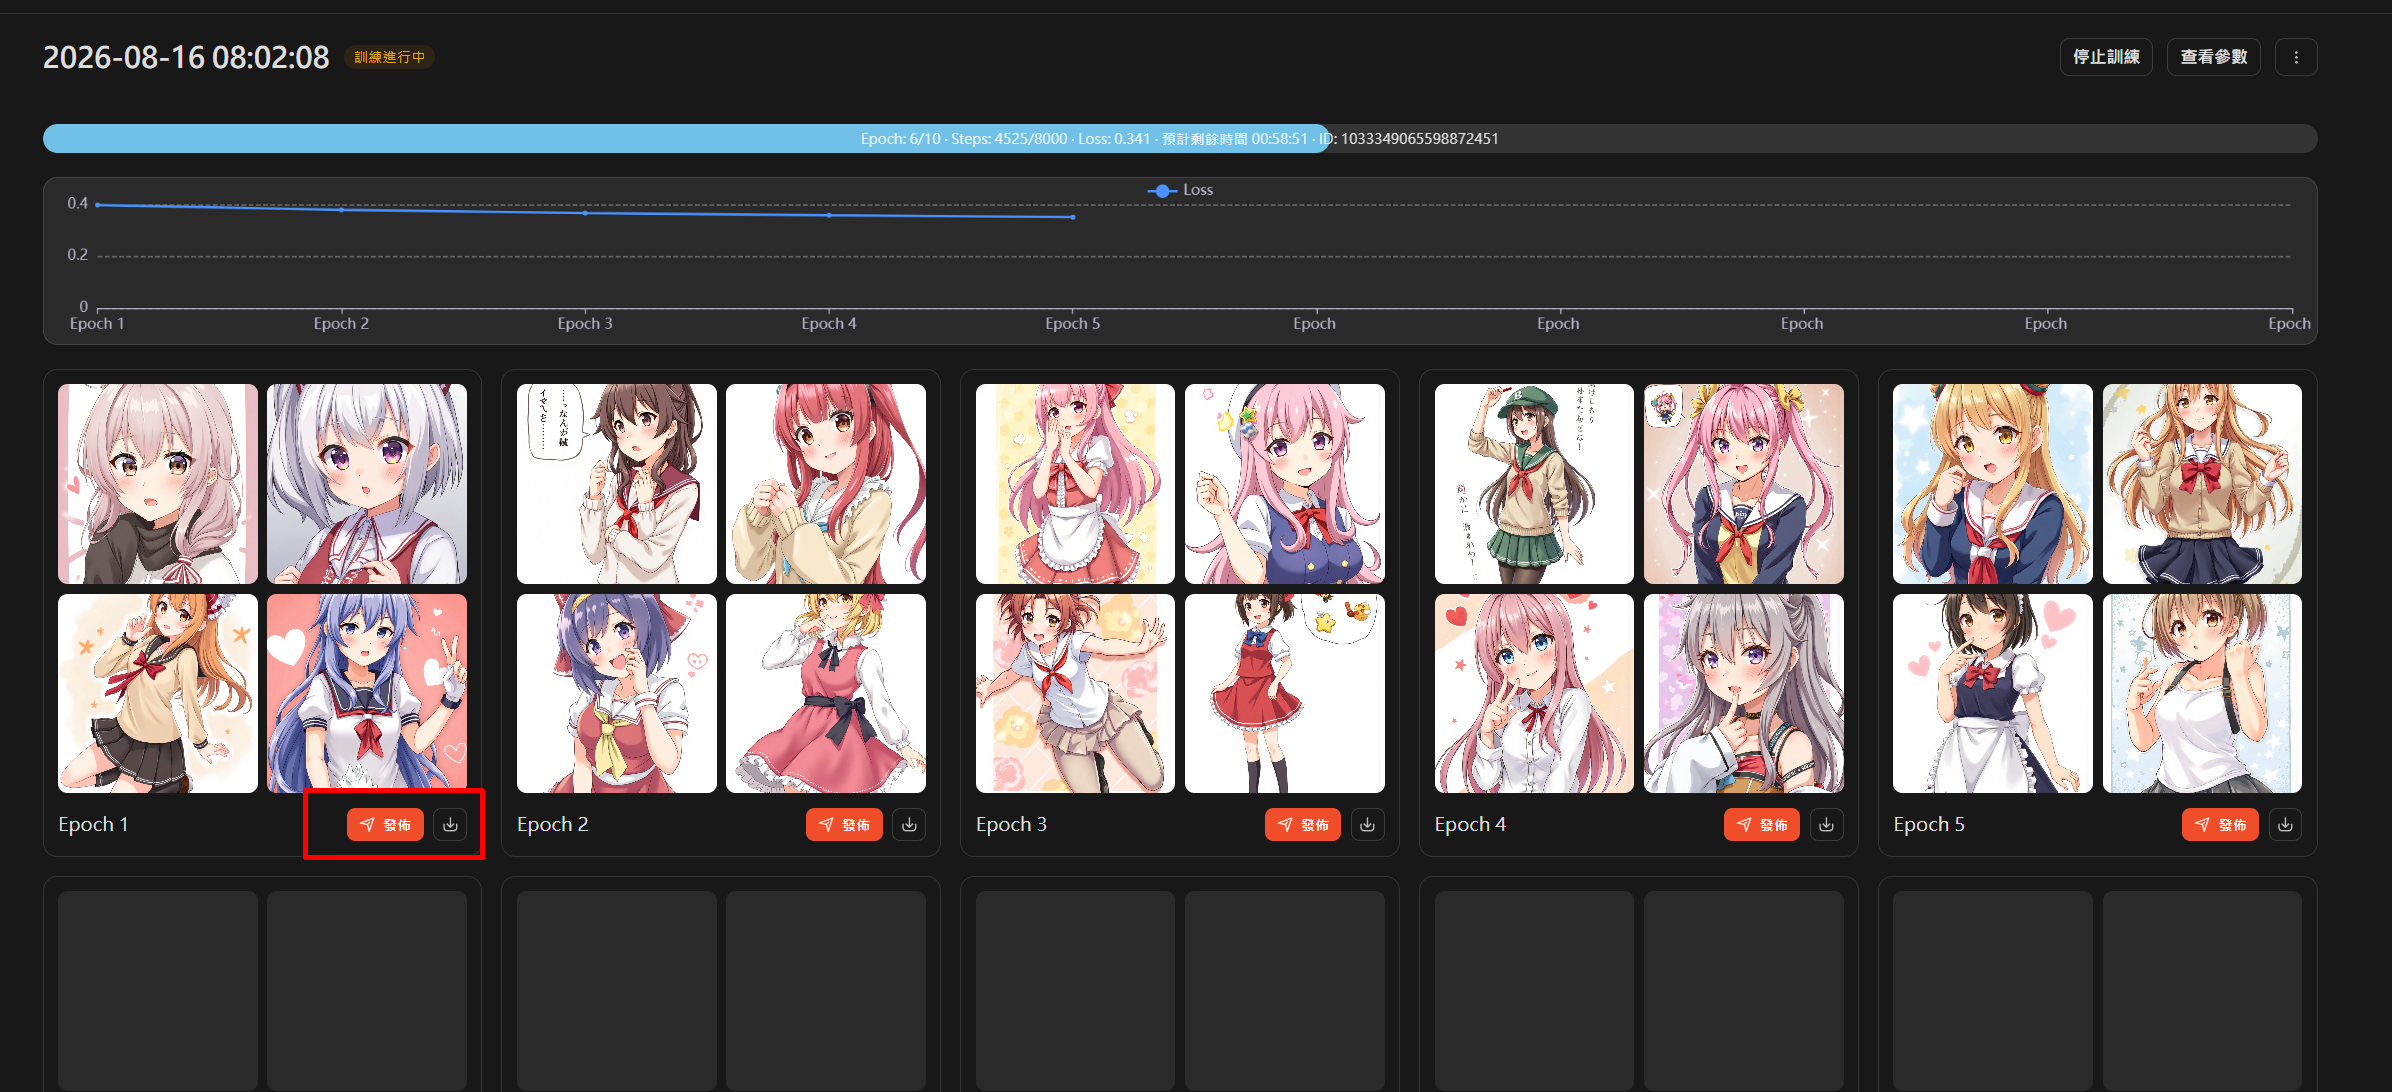
(以上只是示意圖,實際上這個截圖並不是在訓練伊藤潤二的漫畫圖)
D.發佈或下載Lora
在這個網站的結構中,Lora並不是獨立存在的,每個Lora會存在專案之下,而一個專案可以儲存多個Lora。
因此如果是初次使用就要先點擊建立專案,並填好相關資料:
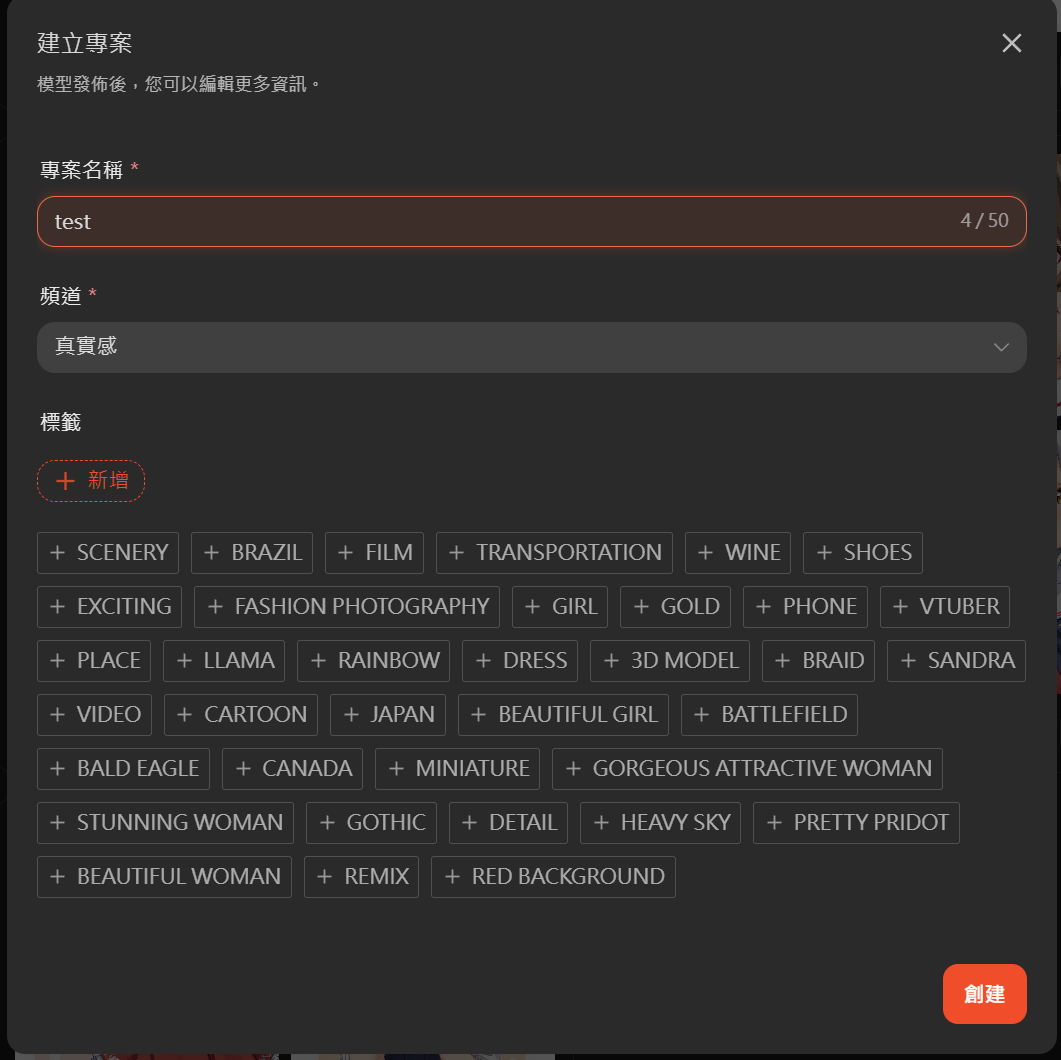
往後也可以分門別類的建立多個專案來管理不同風格的Lora。
專案建好之後就可以再往下填這個Lora的發佈資料了,可以選擇完全公開,也可以選擇私人使用。
實際上不管是專案資料或是Lora資料都是自己看的懂就好了,不用寫的太講究。
當然如果你預計這個Lora是想要公開在網站上供大家使用的話,說明寫的越詳細越好,而且這個網站有獎勵機制,當有人使用你的Lora生圖時,就可以獲得一些獎勵點數。
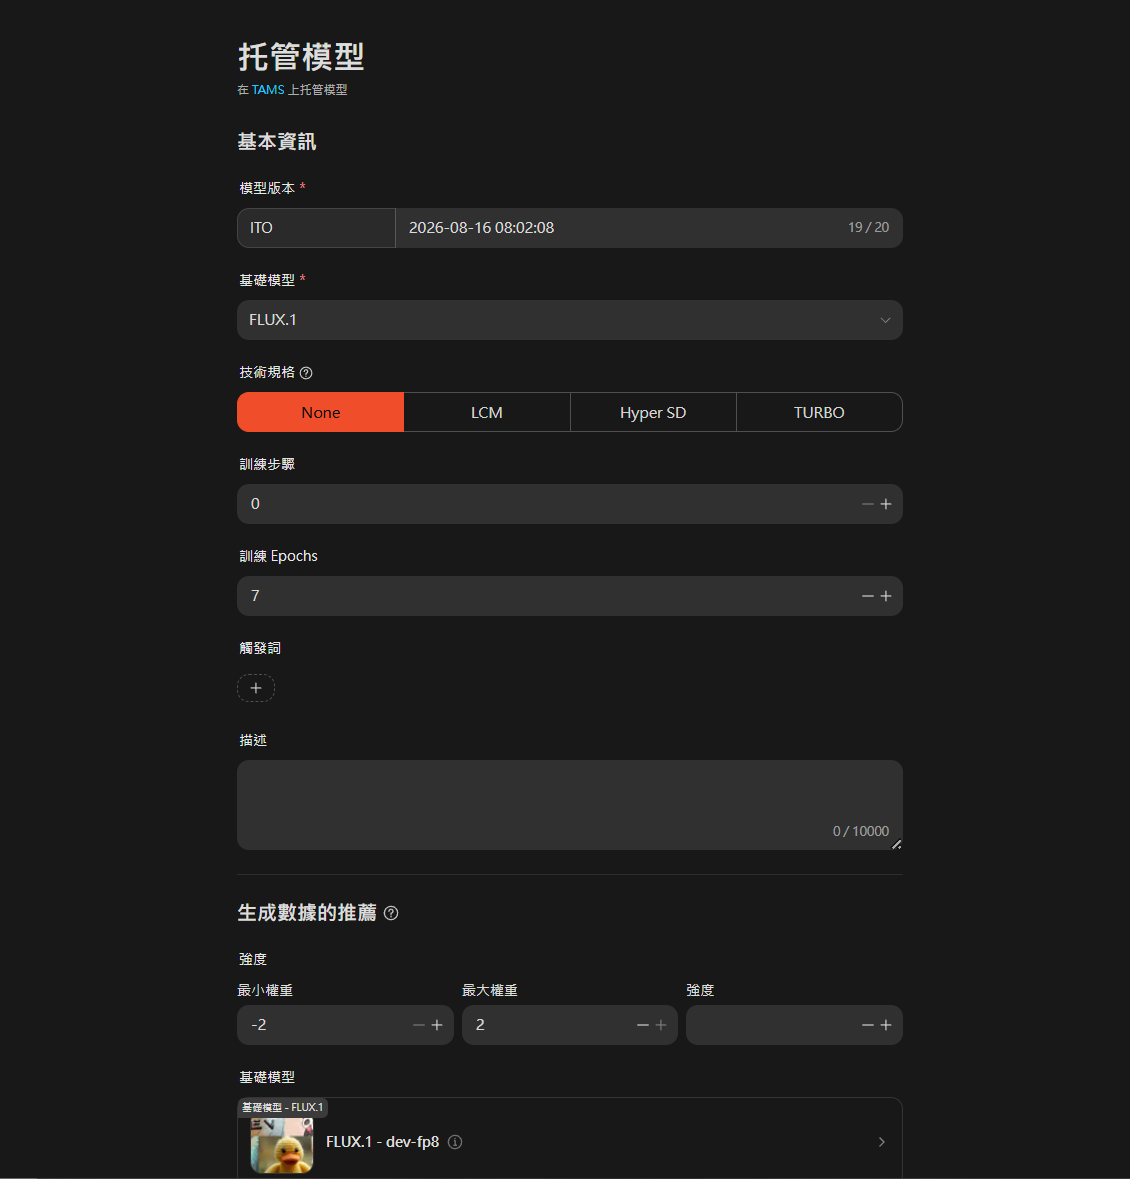
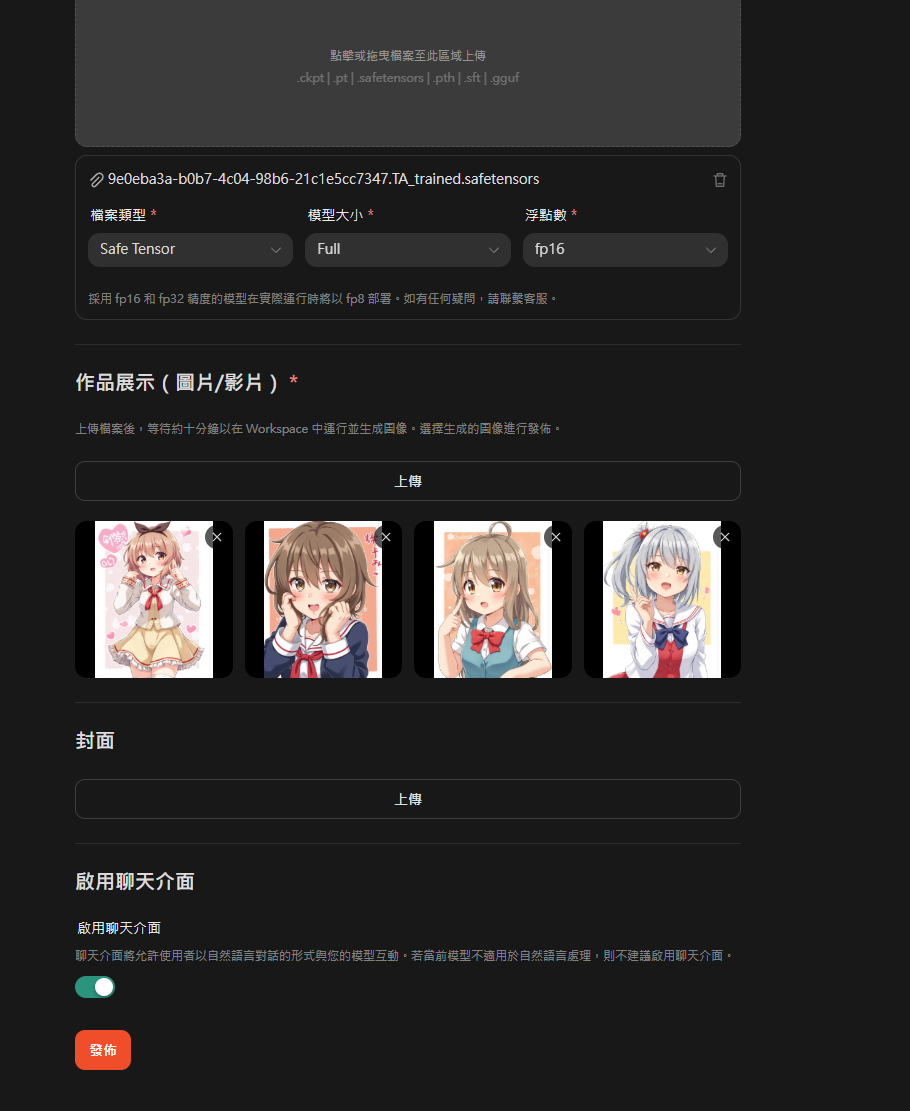
當一切準備就緒後,點擊網頁右上角的帳號圖示回到個人首頁,就可以看到剛剛訓練的Lora了。
在這裡訓練的Lora,可以在這個網站生圖時使用,也可以直接把Lora下載回電腦本機使用。
結論與小提醒:
實際上,使用了這個網站的自動化流程之後,最重要的工作就不是各種軟應體的安裝設定,也不是各種技術流程的學習,最重要的事情只有一件:準備高品質的訓練圖源。
圖源解析度:如果是要訓練SD1.5 Lora,圖片解析度512p就夠了,但目前主流的新模型,不管是SDXL,FLUX或其它較新的模型,圖片解析度最好是在1024p以上。
圖片內容:圖片要能夠明確的展示出想要學習的目標,例如想要學習畫一個杯子,那就以這個杯子的各種角度的照片當做訓練圖源就好,不要又混一堆桌子椅子沒營養的圖片。
如果想要學習一個風格,就不要糾結圖片內的元素,而是要展示同一風格的各種圖片。
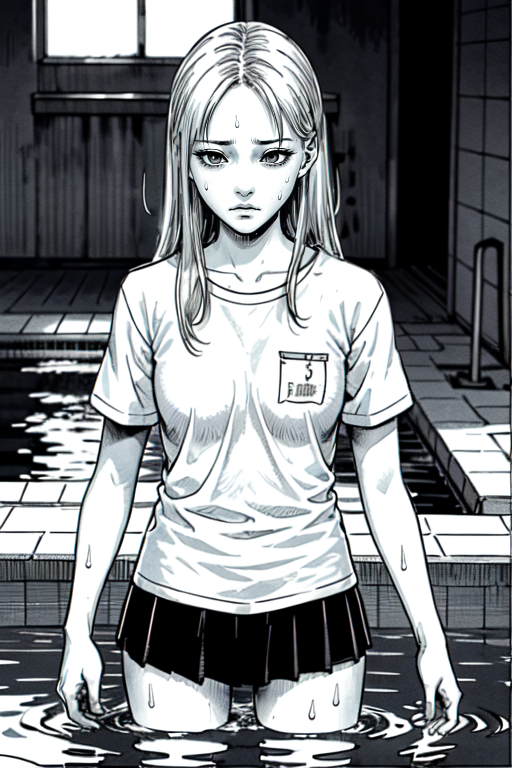
以上方的截圖為例,我想學習伊藤潤二的漫畫風格,並不是把漫畫圖隨便貼一堆就好了,我必須想好我要的學習目標。
伊藤潤二的早期風格與後期風格差異是很大的,其次他在畫恐怖場景與一般場景時的畫風也有十分的不同,他畫怪物與人類的氛圍也完全不同。
以截圖這個例子來說,我要學習的就是伊藤潤二近期畫風下的女性角色。
在搜集訓練圖源時就要預先想好學習的主要目標,因為Lora與繪圖核心大模型不同,Lora一次只能學習一件事情。
圖片裁切:在圖片品質夠好並且主體明確的前提下,不需要在裁切圖片這件事太過刁鑽,如果想要訓練一個人物的外觀,那提供這個人物各個角度各個服裝的圖片就好了,並不需要刻意的把每張圖片都裁切成非常緊縮的單人照或是臉部特寫。通常用這個網站的自動裁切功能就夠了。
以我個人經驗來說,我有比較過先做圖片自動裁切,圖片手動裁切以及直接原圖訓練這三種方案,最後的感受並沒有明顯差異。
數值玄學:網路上的教學文章流傳著各式各樣的數值玄學,常會建議某個數值應該要調高0.1,某個數值應該要降低0.02等等的專業設定教學,但我覺得調整數值前後,並沒有帶來飛躍性的差別,新手就不用糾結了,直接預設值全上就夠了,人生應該要浪費在美好的事物上,而不是深陷數值玄學。
模型的選擇:訓練模型的選擇不太重要,生圖模型的選擇才重要。
在訓練過程中,其實相同體系的不同模型之間的差別不大,例如訓練核心我不管是選擇基本版的FLUX或是其它社群優化後的FLUX版本,最後的訓練結果其實差不多。
有差別的是之後要產圖時的繪圖核心才是關鍵,這個時候選擇社群優化版本模型就有差別了,如果你想畫亞洲女性就最好選擇針對亞洲女性優化過的模型再套用你的Lora,反之如果你選了一個只懂畫外國人的模型版本,這時就算套用了Lora,效果也有限。
總之,這個教學的重點就是一切以輕鬆全自動為目標,花錢了事不要讓自己太辛苦。
伊藤潤二風格的女性
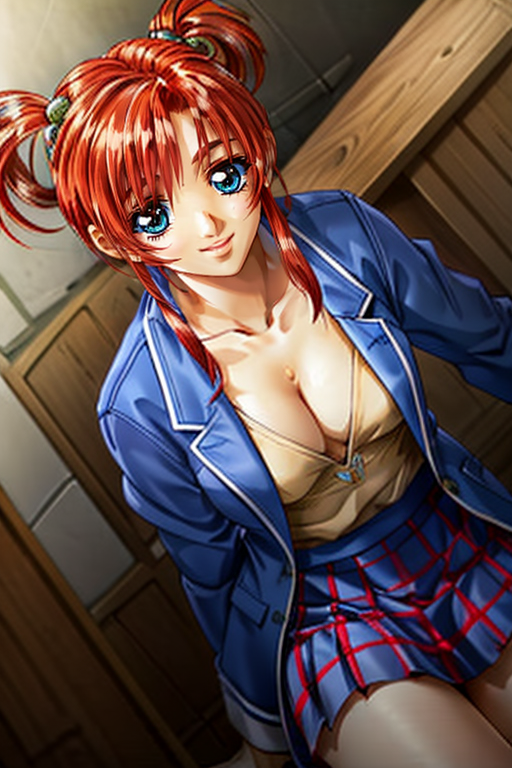
幾十年前的H-Game畫風
留言
還沒有留言,來當第一個吧。
寫留言