簡單易用附帶翻譯功能的影片字幕自動辨識軟體-WhisperSubTranslate
AI字幕-影片自動上字幕又自動翻譯的免費神器(使用WhisperSubTranslate)
1.簡介
上字幕這件事,大概是影片後製裡面最無聊、最花時間、又最不能不做的一環。
聽說台灣人特別愛看字幕,我不知道你信不信,反正我是信了。
一支十分鐘的影片,人工聽打加對時間軸,沒有一兩個小時是搞不定的。如果是外語影片還要再翻一次,那更是折磨。
好在這幾年 AI 語音辨識已經成熟到可以直接拿來用了,OpenAI 的 Whisper 模型開源之後,各種基於它的工具滿地都是。
但問題來了:大部分工具不是要你裝 Python、配環境、跑指令,就是要你把影片丟到別人的雲端伺服器上。
前者對非技術背景的人門檻太高,後者則是你得接受自己的影片被上傳到不知道哪裡去。
如果那是公司內部的會議錄影,或是還沒公開的作品,你大概不會想這樣做。
WhisperSubTranslate 這個工具就是衝著這兩件事來的。
它是一個 Windows 桌面軟體,下載解壓縮就能執行,不用裝 Python、不用配環境、不用註冊帳號。影片丟進去,它在你自己的電腦上跑語音辨識,產出 SRT 字幕檔,然後還可以直接用內建的離線翻譯模型把字幕翻成中文。
整個過程你的影片檔案完全沒有離開過這台電腦。
專案位置:github.com/Blue-B/WhisperSubTranslate
授權是 GPL-3.0,完全免費,作者有開贊助管道但不影響功能。
順帶一提,這個軟體的介面本身就支援中文,不用忍受英文介面。
2.先講清楚它「不會」做什麼
這一段我放在前面講,因為我看過太多人下載完才發現搞錯了。
它是從「聲音」重新產生字幕,不是把影片裡現成的字幕挖出來。
具體來說:
❌ 影片內嵌的字幕軌(MKV 裡面那種可以切換的字幕)→ 它不會去讀
❌ 燒死在畫面上的硬字幕 → 它不會做 OCR
✅ 影片裡的人聲說話 → 這才是它處理的東西
所以如果你的需求是「這部片有日文字幕軌,我想把它翻成中文」,那你需要的是字幕抽取工具,不是這個。
但如果你的需求是「這部片完全沒有字幕,我想要一份字幕」,那就對了。
另外它產出的是 SRT 檔,不是把字幕燒進影片。要壓進畫面的話還是得靠剪輯軟體或 FFmpeg,這一步它不管。
3.安裝:真的只要解壓縮
這大概是整篇文章最短的一段。
去 Releases 頁面 下載最新版的可攜式壓縮檔
解壓縮到任何你喜歡的資料夾
執行
WhisperSubTranslate.exe
沒了。
不用裝 Python、不用裝 FFmpeg、不用手動抓模型。語音辨識模型會在你第一次使用時自動下載,FFmpeg 也已經包在裡面。
唯一要注意的是第一次跑會需要下載模型,要等一下、也要留點硬碟空間,預設模型是1.6GB的large-v3-turbo,但實際上可以自由選擇。
如果你還要用離線翻譯,那再加約 1.1GB。
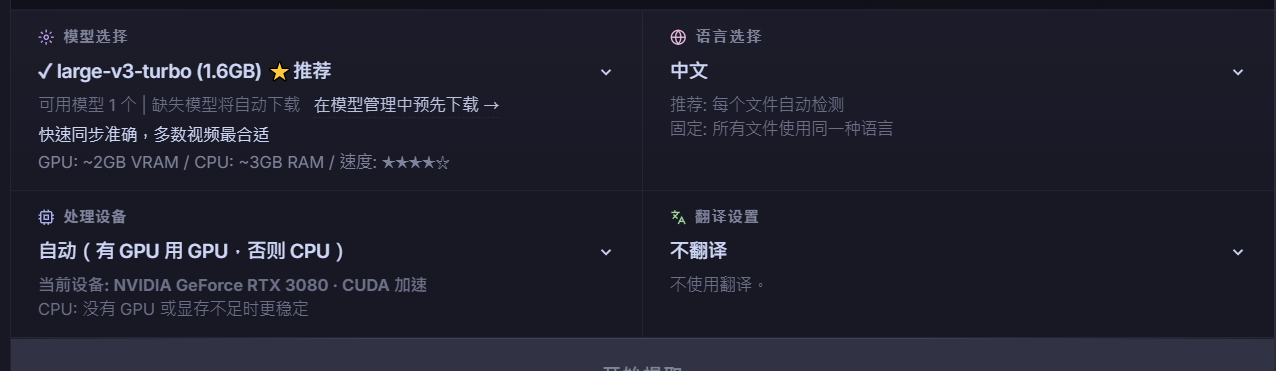
顯示卡的部分它會自動處理:NVIDIA 走 CUDA、AMD 和 Intel 走 Vulkan,都沒有的話就退回 CPU 跑。CPU 當然會慢很多,但至少跑得動。
Linux 使用者要自己從原始碼編譯,指令 README 裡有寫,這邊就不重複了。
4.操作流程
A. 把影片丟進去
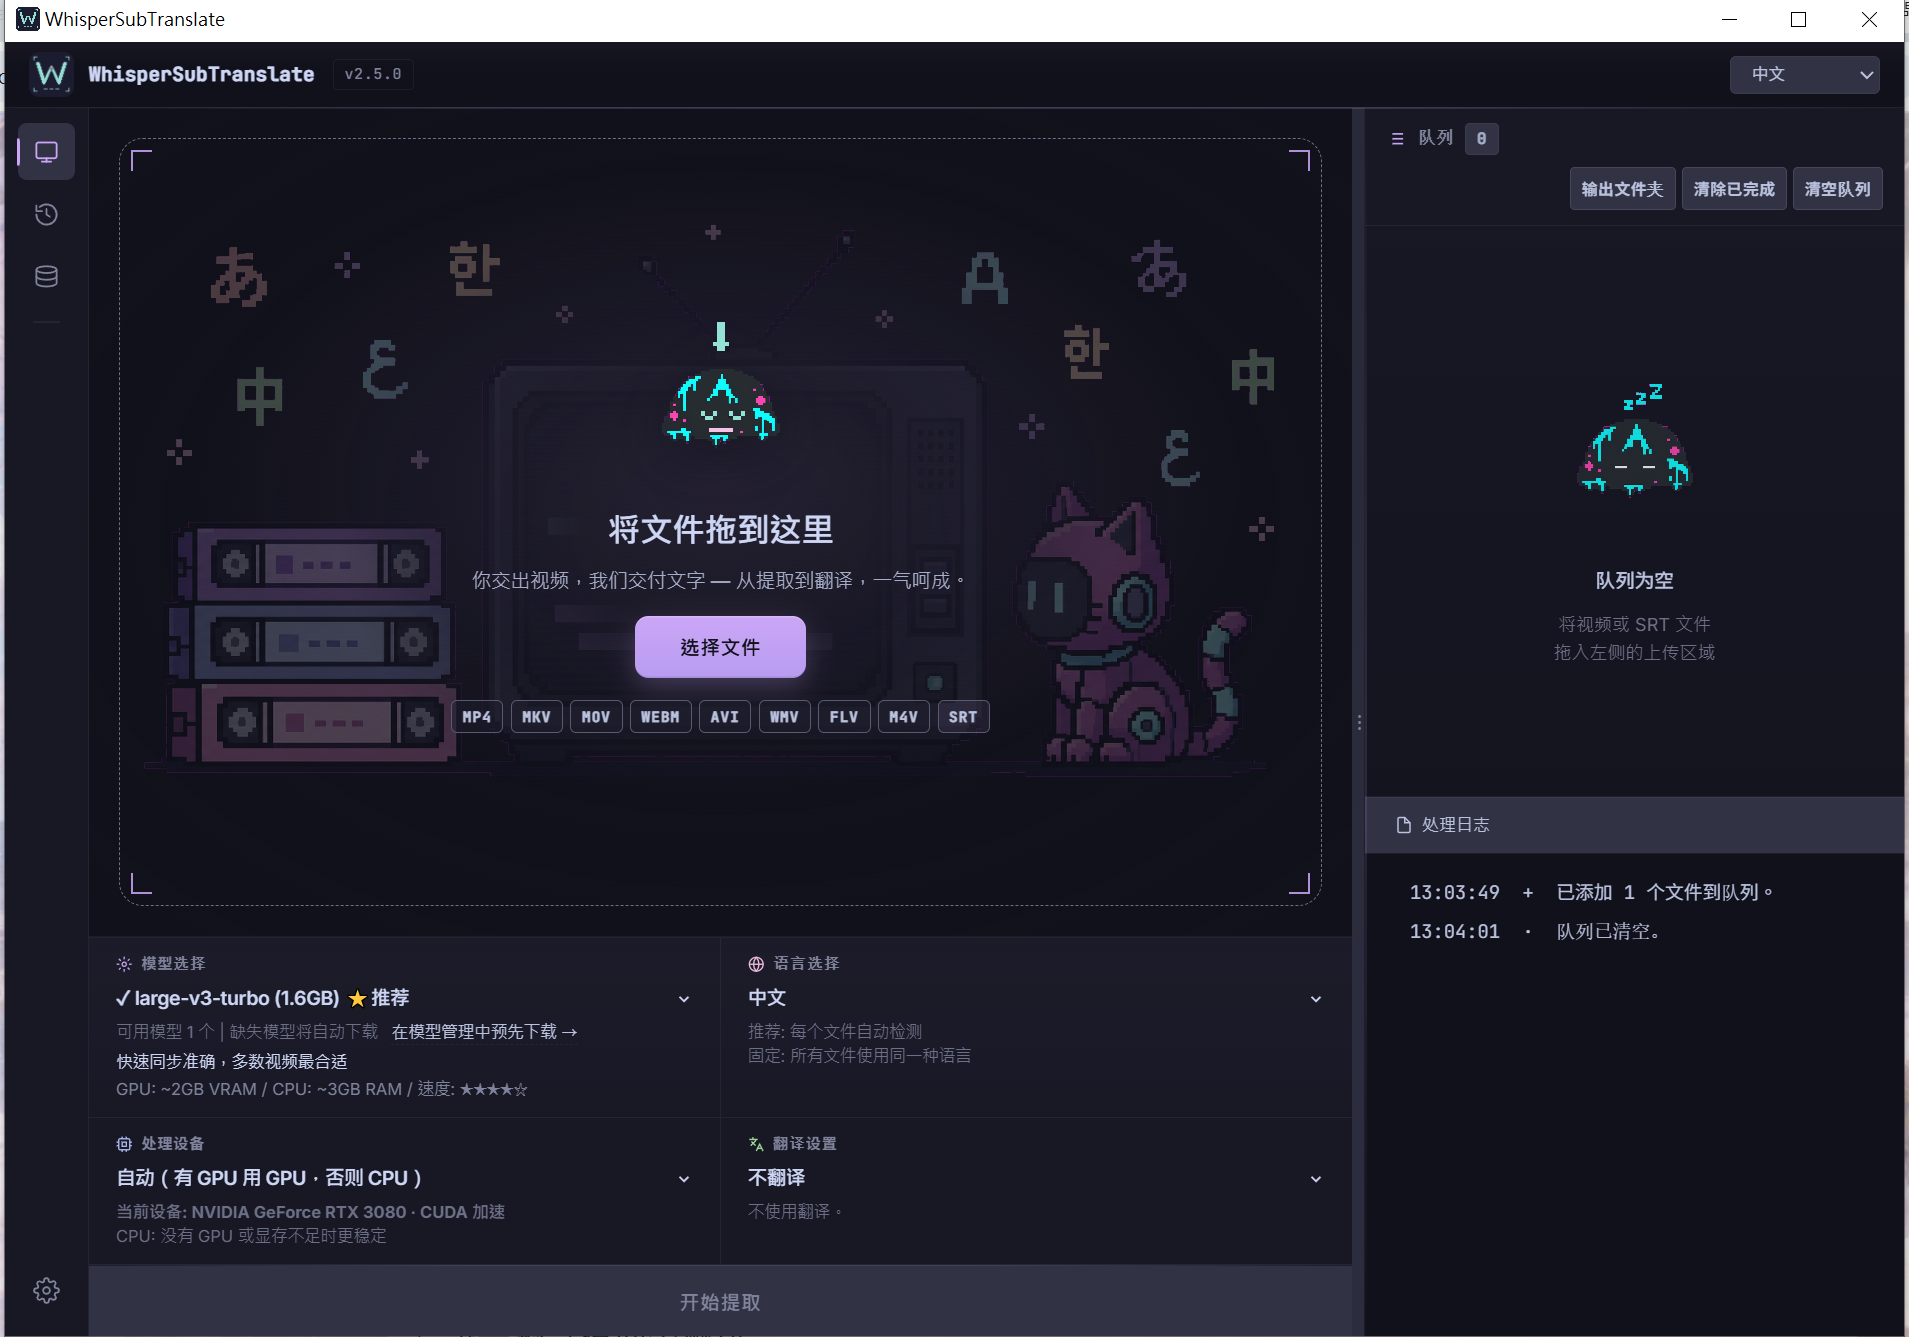
開啟軟體,把影片檔拖進去,或是用按鈕選檔案。
它支援排隊(Queue),所以你可以一次丟一整批影片進去,讓它自己慢慢跑,不用一支一支顧。
B. 選語音辨識模型
這是第一個要做的決定,也是影響品質和速度最大的一個。細節我拉到下一段講,如果你懶得研究,預設的 large-v3-turbo 就是目前綜合表現最好的選擇,直接用它。
C. 選要不要翻譯、用什麼翻
如果你只是要原文字幕,這步可以跳過,直接產 SRT 就好。
要翻譯的話,預設會用內建的離線模型(騰訊的 Hy-MT2),不用金鑰、不用網路、不用錢。想要更好的品質也可以接 DeepL 或各家 AI 的 API,這部分一樣拉到後面單獨講。
翻譯目標語言目前支援 15 種:中文、英文、日文、韓文、西班牙文、法文、德文、義大利文、葡萄牙文、俄文、匈牙利文、阿拉伯文、波蘭文、土耳其文、波斯文。
D. 開始跑,然後去做別的事
按下開始之後就是等。過程中有即時進度可以看。
跑完會得到 SRT 檔。如果有開翻譯,就會再多一份翻譯後的版本。
軟體內建工作歷史紀錄(最多 200 筆),而且是存在本機的,可以在設定裡關掉。
我的經驗是辨識準確率大約在七到八成,因為這是一般狀況。如果你整部影片的台詞都是字正腔圓,音質乾淨,無背景雜音就有機會達到百分百準確,但我們不能確保每次都會有個完美的前置條件。
事實上字幕能夠靠自動化處理到八成以上的準確率就已經省下非常多的心力了,剩下的工作就是挑錯字而已。
5.語音辨識模型怎麼選
這是新手最容易卡住的地方,所以講細一點。
模型就是「檔案越大、辨識越準、但跑越慢、吃越多顯示卡記憶體」。以下是官方列出的規格:
模型 | 檔案大小 | 需要 VRAM | 速度 | 適合情況 |
|---|---|---|---|---|
tiny | ~75MB | ~1GB | 最快 | 只是想試試看能不能動 |
base | ~142MB | ~1GB | 快 | 老電腦、沒有獨顯 |
small | ~466MB | ~1GB | 中 | 堪用,品質普通 |
medium | ~1.5GB | ~2GB | 中 | 品質不錯 |
large-v3-turbo(預設) | ~809MB | ~2GB | 快 | 大多數人直接選這個 |
large-v3 | ~3GB | ~4GB | 慢 | 要最高辨識準確度 |
large-v2 Sync | ~4.4GB | ~4.5GB | 慢 | 專門修字幕不同步 |
large-v2 Sync Lite | 與 Sync 共用 | ~3GB | 慢 | 同上,但省顯存 |
我的建議很簡單:
預設的 large-v3-turbo 就是甜蜜點。 它只有 809MB,卻是官方標註「綜合表現最好」的那一個,速度快、吃的顯存也少。一般人不用想太多,用它就對了。
會需要往上換 large-v3 的情況,通常是音質很差、口音很重、或是專有名詞很多的影片。但它要 3GB 檔案、4GB 顯存,速度也明顯慢下來,換來的準確度提升不見得有你想像中大。
會需要往下換小模型的情況只有一個:你的電腦真的跑不動。 沒有獨立顯卡的筆電,用 base 或 small 至少還能跑完。
6.翻譯引擎怎麼選
這裡的選擇比語音模型更多,但反而比較好決定,因為分界很清楚。
引擎 | 要網路 | 要金鑰 | 費用 | 備註 |
|---|---|---|---|---|
Hy-MT2 1.8B(內建預設) | 否 | 否 | 免費 | 約 1.13GB,VRAM 2GB / RAM 4GB |
Hy-MT2 7B | 否 | 否 | 免費 | 約 6.16GB,VRAM 8GB / RAM 12GB |
MyMemory | 是 | 否 | 免費 | 每 IP 每天約 5 萬字上限 |
DeepL | 是 | 是 | 免費額度 50 萬字/月 | 輸出穩定 |
Gemini | 是 | 是 | 免費或極低價 | CP 值最高的線上選項 |
OpenAI GPT | 是 | 是 | 付費 | 有上下文理解 |
Claude | 是 | 是 | 付費 | 上下文理解最強 |
自訂 OpenAI 相容端點 | 是 | 是 | 看你接誰 | 可接 OpenRouter、Ollama、vLLM |
如果你不想花任何心力:用預設的 Hy-MT2 就好。
它是騰訊開源的翻譯模型,直接包在軟體裡,不用金鑰、不用網路、不用錢,而且翻譯內容完全不會離開你的電腦。依騰訊官方公布的評測數據,這個模型系列在標準機器翻譯測試上是能跟商用翻譯 API 正面對打的,某些項目還贏。
只有 1.13GB 而已,吃 2GB 顯存,門檻非常低。對絕大多數人來說這一個就夠了。
如果你想要更好的品質:Gemini 是 CP 值最高的選項,有免費額度,申請金鑰也不麻煩。
如果你要處理一小時以上的長片,請不要用 MyMemory。 它有每日字數上限,長片很容易撞到,撞到之後就會卡住變得很慢。改用 Gemini、DeepL 或內建的離線模型都好。
至於 GPT 和 Claude 這類大模型,它們的優勢在於理解上下文——翻譯字幕最痛的問題就是每一句被切開來看,代名詞、語氣、人稱全部翻錯,大模型在這方面明顯好很多。但要付費,而且長片會燒掉不少錢,看你的需求值不值得。
API 金鑰是存在本機的,而且用作業系統層級的安全儲存機制保護,不會被打包進去或上傳。
7.字幕跑掉怎麼辦?
這是我覺得這個軟體最貼心的一個設計,值得單獨講。
用 Whisper 產字幕,偶爾會遇到一種很崩潰的狀況:字幕內容是對的,但時間軸整個飄掉,播到後面越差越多,根本沒辦法用。
這通常發生在非英語的影片上,日文、韓文、中文特別容易中獎。
這個軟體提供了兩個專門處理這件事的模型:large-v2 Sync 和 large-v2 Sync Lite。
它們走的是另一套引擎(Faster-Whisper),專門就是來修時間軸的。兩者共用同一個模型檔,所以只會下載一次,差別在 Sync Lite 用 int8 量化,吃的顯存比較少(3GB vs 4.5GB)。
要注意的是:
這套引擎要另外下載,引擎約 1.4GB、模型約 3GB,加起來要 4.4GB,不小
速度慢
只在正常模型跑出來不同步的時候才用它,平常沒必要
英文影片基本上用 large-v3-turbo 就不太會有這個問題,不用預先下載。
8.資料放在哪、可以放隨身碟嗎
預設的話,模型、設定、API 金鑰、工作紀錄都會放在 Windows 使用者資料夾底下:
%APPDATA%\whispersubtranslate\
問題是模型動輒好幾 GB,如果你的系統碟是小容量 SSD,塞幾個模型下去就很痛。
解法很簡單:在執行檔旁邊建一個叫 portable-data 的資料夾,軟體就會自動把所有資料改放到那裡。
這樣你可以整包丟到外接硬碟或隨身碟,換一台電腦插上去就能用,設定和模型都跟著走。
補充一個冷知識:如果你的 Windows 使用者名稱是中文或其他非英文字元,模型路徑會自動改放到 C:\Users\Public\WhisperSubTranslate\_models。這是作者特地處理過的相容性問題,台灣使用者用中文帳號名稱的不少,算是有照顧到。
9.常見問題
Q:這真的完全免費嗎?
語音辨識和內建的離線翻譯是完全免費的,沒有次數限制、沒有浮水印、不用註冊。只有你自己選擇去接 DeepL、OpenAI 那些外部服務時才要照他們的規矩付費。
Q:沒有顯示卡可以用嗎?
可以,會退回 CPU 運算,但會慢很多。建議搭配小一點的模型(base 或 small)。
Q:支援哪些語言的影片?
語音辨識支援 100 種以上的語言,這是 Whisper 本身的能力。翻譯的目標語言則是 15 種,中文有在裡面。
Q:可以一次處理很多影片嗎?
可以,有內建排隊功能,丟一整批進去讓它慢慢跑就好。
Q:我的影片會被上傳嗎?
語音辨識階段完全在本機,不會。翻譯階段如果你選了線上引擎(DeepL、Gemini 那些),那字幕文字會送去那個服務,但影片本身不會。想要完全不外流就用內建的離線翻譯。
Q:Mac 可以用嗎?
目前主要是 Windows,Linux 需要自己編譯。Mac 官方沒有提供。
結論與小提醒
用完一輪之後,我覺得這個工具最大的價值不在於它多強,而在於它把門檻降到幾乎是零。
同樣的事情你當然可以自己裝 Python 環境、抓 Whisper 模型、寫指令來做,但那是另一個層級的工作量。這個東西就是解壓縮、拖檔案、按開始,三步。
WhisperSubTranslate並不是僅此一家的字幕軟體,但他是免費開源軟體,同時附帶翻譯功能這就相對少見了。
另外,論技術層面,它可能不是頂尖第一名的,但它簡單易用是一個非常重要的特色。
因為我也試用過類似Faster Whisper XXL GUI,Subtitle Edit這類相同賽道的知名字幕軟體,但顯而易見的,這些軟體的"工程味"就很重,密密麻煩的設定項目一下全砸了過來,週邊細部功能也給的齊全,說專業確實是很專業,但只是業餘偶爾想做個自動字幕,這樣的軟體就顯得太沉重,操作上也有點門檻。
WhisperSubTranslate介面簡單,開箱即用就是我最後推薦這個軟體的主因。
幾個實際使用上的提醒:
先確認你的需求是「產生字幕」而不是「抽取字幕」。 這點我在第二段特別強調過,但真的太多人搞錯了。它只處理聲音。
音質才是決定成敗的關鍵。 這跟訓練 Lora 要準備好圖源是同一個道理——再強的模型也救不了背景吵雜、回音嚴重、多人同時講話的錄音。如果你手上有原始音軌,用原始音軌不要用壓過的影片,差別很大。
不要一開始就下載最大的模型。 先用預設的 large-v3-turbo 跑一小段看看結果,覺得不夠好再往上換。很多人一上來就抓 large-v3,結果等半天、吃爆顯存,換來的品質提升根本感覺不出來。
翻譯品質不要期待一次到位。 字幕翻譯的先天問題就是句子被時間軸切碎,缺乏上下文。就算用最貴的大模型,人名、專有名詞、雙關語還是會出錯。把它當成「省下九成打字時間的草稿」,最後自己校一遍,這才是合理的使用方式。
AI 產出的字幕請一定要看過再發佈。 它會犯的錯通常不是拼字錯誤,而是「聽成另一個意思通順的句子」,這種錯誤最難發現也最尷尬。
免費、開源、本機執行、中文介面,這幾個條件湊在一起的工具其實不多。如果你有影片需要上字幕,這個很值得放進工具箱。
相關連結
下載頁面:Releases
語音辨識核心:whisper.cpp
內建翻譯模型:騰訊 Hy-MT2
留言
還沒有留言,來當第一個吧。
寫留言